L’étude en bref. Nous avons relevé les liens internes contextuels de 7 472 articles du blog de HubSpot et les avons croisés avec 188 020 positions Google aux États-Unis, de juillet à octobre 2026.
La méthode est celle de notre étude sur six blogs d’éditeurs de logiciels.
Notre constat tient en une phrase. Sur HubSpot, ce qui fait la différence en haut de Google, c’est la qualité de chaque lien, et non plus le fait d’être relié.
- Les articles qui reçoivent leurs liens d’articles déjà dans le top 10 ont 65 % de chances en plus d’être en position 1, et 28 % d’être dans le top 10.
- Une page a 44 % de chances en plus d’être dans le top 10 sur une requête quand un lien vers elle prend des mots de cette requête comme ancre.
- Les articles dont les ancres reprennent les mots du H1 des pages qu’ils relient ont 22 % de chances en plus d’être dans le top 10.
- Pour ces trois leviers, l’écart est plus grand pour le top 3 que pour le top 10.
- Le simple fait d’être relié va avec plus de chances d’apparaître dans Google, pas d’être en haut, contrairement aux blogs des éditeurs.
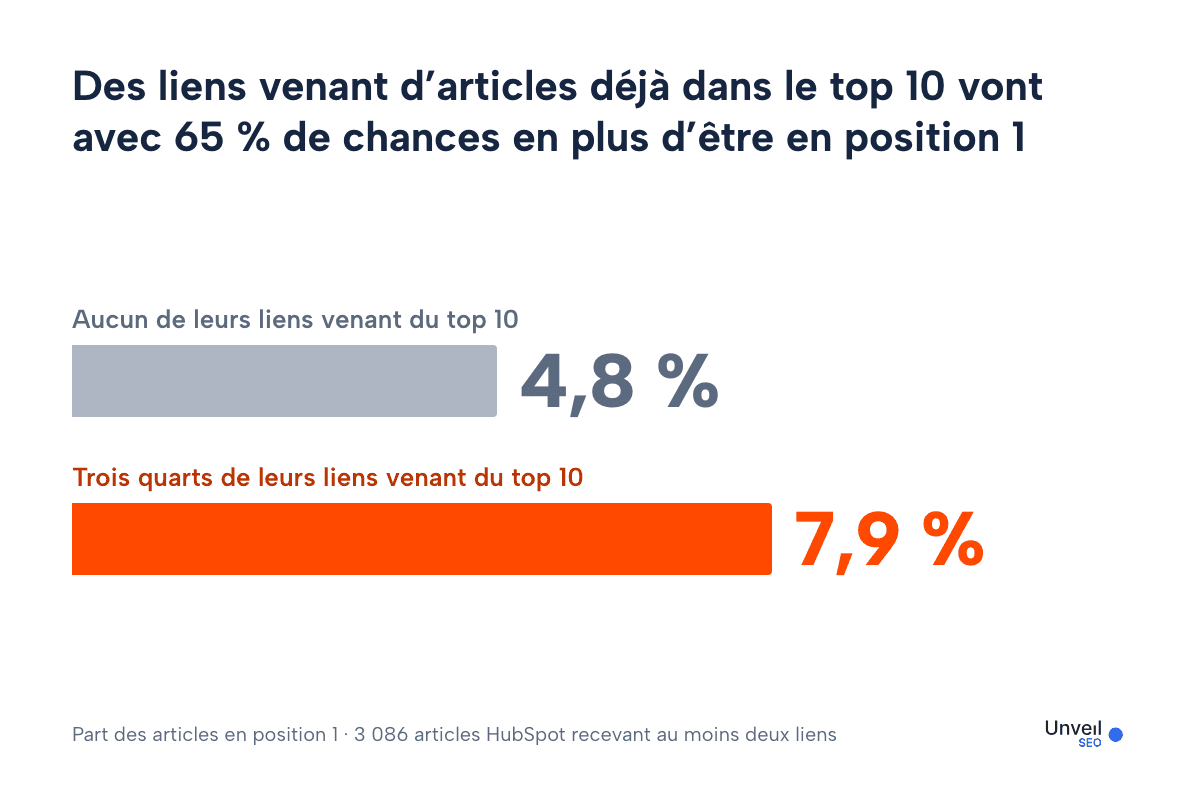
Tous les pourcentages sont des écarts relatifs. « 65 % de plus » veut dire passer de 4,8 % à 7,9 % d’articles en position 1, et chaque chiffre est donné avec son point de départ dans l’article.
Ils comparent des articles de longueur, d’âge, de backlinks et de section comparables. Ils montrent une association, pas encore une preuve d’effet.
Pour une équipe contenu, le premier geste consiste à relier les articles délaissés depuis des articles déjà dans le top 10, avec une ancre tirée d’une requête que vise la page.
Dans notre étude sur six blogs d’éditeurs de logiciels pour artisans, être relié faisait une vraie différence.
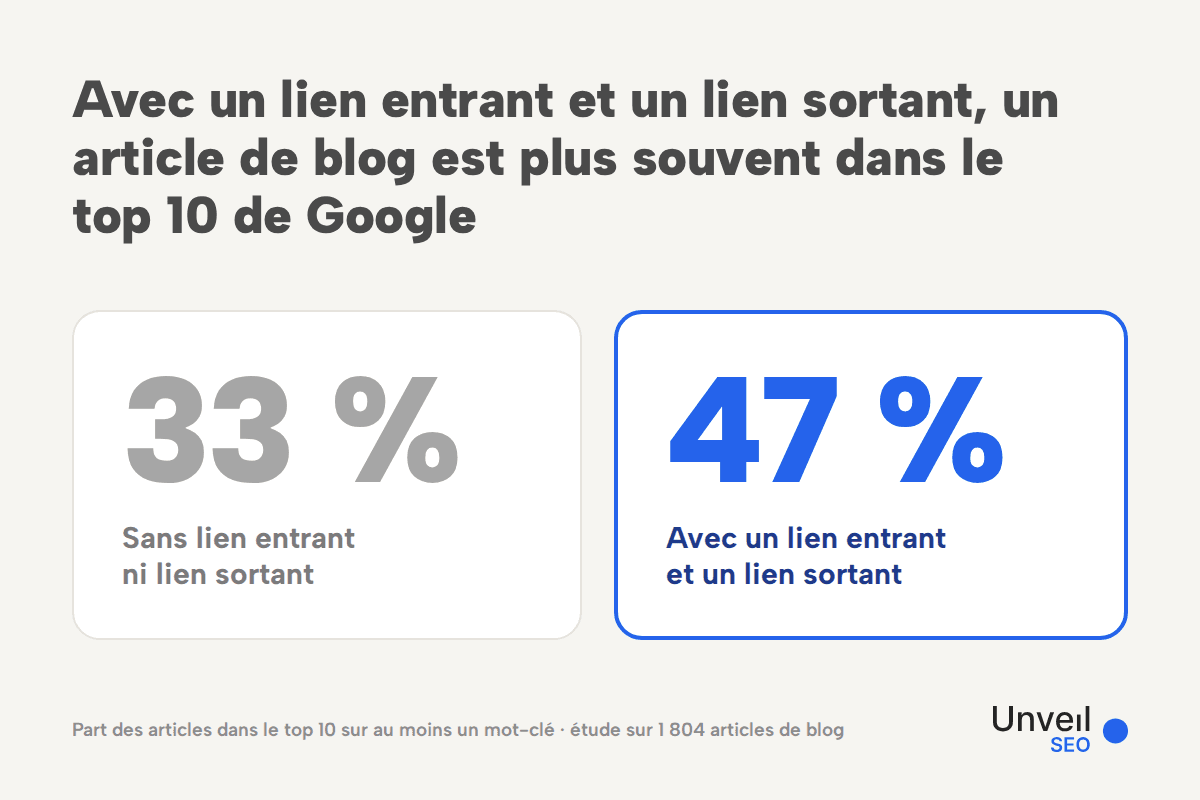
Un article qui recevait et donnait au moins un lien dans son texte était dans le top 10 de Google dans 47 % des cas, contre 33 % pour un article isolé.
Deux questions restaient ouvertes. Ces blogs étaient trop petits pour dire si l’ancre d’un lien compte, ni si ajouter des liens au-delà du premier change quelque chose.
Le blog de HubSpot était l’endroit où les poser. Il compte 7 472 articles, des backlinks sur presque tous, et l’équipe qui l’anime a popularisé les topic clusters.
Chez Unveil SEO, notre plateforme construit le maillage interne contextuel à partir du texte qu’un site a déjà publié. Nous avons appliqué au blog de HubSpot exactement la même méthode qu’aux éditeurs.
Ce qu’est un lien contextuel. C’est un lien placé dans le texte d’un autre article, dans une phrase, une liste ou un tableau. Les menus, pages de liste, boutons, images et blocs de suggestion ne comptent pas.
La réponse tient en une phrase. Sur HubSpot, ce qui fait la différence en haut de Google, c’est la qualité de chaque lien, et non plus le fait d’être relié.
Nous avons mesuré cette qualité par trois leviers, la page d’où vient un lien, son ancre, et les ancres qu’un article donne. Le premier ressort le plus, tout en haut des résultats.
Des liens venant d’articles déjà dans le top 10 vont avec 65 % de chances en plus d’être en position 1
Le premier levier est la source d’un lien, l’article d’où il vient.
Pour chaque article, nous avons compté combien des liens qu’il reçoit viennent d’articles déjà dans le top 10 sur au moins un mot-clé.
Nous avons gardé les 3 086 articles qui reçoivent au moins deux liens, et comparé deux groupes, ceux qui n’ont aucun lien venant d’un article du top 10 et ceux dont les trois quarts des liens en viennent.
- Dans le top 10. 36 % des articles sans source dans le top 10, 46 % des autres, soit 28 % de plus.
- Dans le top 3. 12 % contre 17 %, soit 41 % de plus.
- En position 1. 4,8 % contre 7,9 %, soit 65 % de plus.
Plus la position est haute, plus l’écart est grand. C’est aussi le seul des trois leviers dont on peut mesurer l’écart jusqu’à la position 1.
Seuls 298 articles sont en position 1, donc ce chiffre a une marge d’erreur plus large. Il reste statistiquement significatif.
La comparaison se fait à sujet aussi porteur, ce que nous expliquons juste après. Un lien depuis une page déjà bien classée va avec de bien meilleures positions qu’un lien depuis une page qui ne l’est pas.
Quand les trois quarts des liens reçus viennent d’articles du top 10, la part en position 1 passe de 4,8 % à 7,9 %, et dans le top 10 de 36 % à 46 %.
Et si c’était simplement le sujet qui marche ?
L’objection est juste. Les articles du top 10 traitent souvent de sujets qui marchent, et les articles qu’ils relient peuvent partager cette chance.
Pour la tester, nous avons donné à chaque article un score de sujet, la part de ses 10 articles les plus proches qui sont dans le top 10. Un score élevé veut dire que le sujet marche bien sur HubSpot.
Comparer des articles au même score de sujet ne réduit l’écart que légèrement.
- Sans le score de sujet, les écarts sont de 35 % pour le top 10, 43 % pour le top 3 et 76 % pour la position 1.
- Avec, ils sont de 28 %, 41 % et 65 %, les chiffres ci-dessus.
L’avantage d’un lien venant d’une page bien classée ne s’explique pas par le seul fait que son sujet marche.
La source dit d’où part un lien. Son autre bout, l’ancre, dit où il va.
Une ancre tirée d’une requête compte presque autant que cette requête dans le H1
Le deuxième levier est l’ancre, le texte cliquable d’un lien. Nous voulions savoir si ses mots changent les requêtes sur lesquelles la page visée se classe.
Une ancre est tirée d’une requête quand tous ses mots se retrouvent dans cette requête. Il lui faut au moins deux mots porteurs de sens, les mots comme « le » ou « de » ne comptant pas.
- La page. « What is NPS » (Qu’est-ce que le NPS ?), sur le blog de HubSpot.
- Ses ancres. 34 liens venant d’autres articles disent « Net Promoter Score », et 3 disent « NPS surveys ».
- La correspondance. « NPS surveys » est tirée de la requête « nps survey », mais pas de « nps scale ».
L’exemple illustre la mesure, pas un résultat.
L’ancre « NPS surveys » est tirée de la requête « nps survey », pas de « nps scale ».
Nous avons ensuite comparé chaque page avec elle-même, requête par requête, sur 5 820 articles. Une page se classe mieux sur les requêtes d’où sont tirées ses ancres que sur ses autres requêtes.
- Dans le top 10. Sur 10,4 % de ces requêtes, contre 7,2 % de ses autres requêtes, soit 44 % de plus.
- Dans le top 3. Sur 1,9 % contre 1,1 %, soit 65 % de plus.
Pour comparer, avoir la requête dans le H1 ou le titre de la page va avec 3,8 points de top 10 en plus, et une ancre tirée de cette requête avec 3,2. L’ancre pèse presque autant que le H1.
Une page est dans le top 10 sur 10,4 % des requêtes d’où sont tirées ses ancres, contre 7,2 % sur les autres.
N’est-ce pas simplement des pages optimisées pour ces requêtes ?
C’est la première objection. Une analyse de 23 millions de liens internes sur 1 800 sites trouvait bien plus de trafic sur les pages recevant au moins une ancre exacte, et son auteur notait qu’elles sont peut-être mieux optimisées.
Notre comparaison évite ce piège. Chaque page est comparée à elle-même, si bien que sa qualité, ses backlinks et son âge restent les mêmes d’une requête à l’autre.
Nous avons aussi tenu compte de la présence de la requête dans le H1 ou le titre, de son volume de recherche et de sa difficulté.
Une ancre proche du mot-clé, n’est-ce pas de la sur-optimisation ?
On entend souvent qu’une ancre interne trop proche du mot-clé est risquée. Sur HubSpot, rien ne justifie cette crainte.
Ce qui compte, c’est que les mots de l’ancre viennent de la requête, pas que l’ancre contienne toute la requête. Les ancres qui contiennent la requête entière vont avec un écart bien plus faible.
L’ancre utile est une courte expression tirée de la requête, comme « NPS surveys », plutôt que le mot-clé entier calé dans une phrase. Les consignes de Google sur les liens vont dans ce sens, avec des ancres descriptives.
Une lecture possible de la variété des ancres. La même analyse de 23 millions de liens trouvait plus de clics sur les pages recevant des ancres plus variées.
Si chaque ancre tirée d’une requête différente va avec de meilleures positions sur cette requête, des ancres variées couvriraient simplement plus de requêtes.
Jusqu’ici, les liens qu’un article reçoit. Ceux qu’il donne disent aussi quelque chose de lui.
Les articles qui relient leurs voisins avec des ancres précises sont plus souvent en haut de Google
Le troisième levier porte sur les liens qu’un article donne, et non sur ceux qu’il reçoit. Il va contre une intuition répandue, sur laquelle nous revenons plus bas.
Ce qu’est une ancre précise. Une ancre est précise quand ses mots se retrouvent dans le H1 de la page visée. Pour chaque article, nous avons fait la moyenne de la précision de toutes les ancres qu’il place.
« What is a blog » (Qu’est-ce qu’un blog ?), sur le blog de HubSpot, donne les deux.
- Une ancre précise. « best blogging platforms » pointe vers « The 11 best blogging platforms », dont le H1 contient tous ses mots.
- Une ancre peu précise. « high-quality, consistent content » pointe vers « 12 Benefits of Content Marketing », qui n’a que « content » en commun avec elle.
L’exemple illustre la mesure, pas le classement de cet article.
« best blogging platforms » est une ancre précise, puisque tous ses mots figurent dans le H1 de la page visée.
Parmi les 5 355 articles qui donnent des liens, nous avons comparé ceux du bas de l’échelle, où environ un mot d’ancre sur cinq se retrouve dans le H1 visé, à ceux du haut, où tous s’y retrouvent.
- Dans le top 10. 32 % en bas de l’échelle, 39 % en haut, soit 22 % de plus.
- Dans le top 3. 10 % contre 14 %, soit 36 % de plus.
L’écart tient même quand on contrôle de plus près l’âge de l’article et sa dernière mise à jour. Il ne tient donc pas à l’époque où l’article a été écrit.
Les articles aux ancres les plus précises sont dans le top 10 dans 39 % des cas, contre 32 % pour les moins précises.
Donner des liens ne disperse-t-il pas l’autorité de la page ?
C’est l’une des idées les plus répandues en SEO. Chaque lien qu’un article donne lui retirerait une part de son autorité, si bien qu’il faudrait rationner les liens sortants.
L’idée remonte à la formule du PageRank que Sergey Brin et Larry Page ont publiée en 1998. Le score d’une page y vient des pages qui la citent, et chacune partage son propre score entre tous les liens qu’elle donne.
Un lien sortant réduit ce que reçoit chaque page visée, pas le score de celle qui le donne. Google a beaucoup changé depuis 1998, cela ne prouve rien pour aujourd’hui, mais la formule d’origine ne pénalisait pas la page qui lie.
Le conseil que nous abandonnerions. C’est pour nous l’idée la plus à côté du maillage interne. Une équipe devrait limiter les liens d’un article selon leur pertinence, pas par peur de perdre de l’autorité.
Nos données vont dans ce sens, sans tester directement la dilution. Sur HubSpot, les articles aux ancres précises sont plus souvent en haut, et chez les éditeurs, donner un lien contextuel allait avec 8 points de top 10 en plus.
Nos données ne disent pas pourquoi les ancres précises vont avec un meilleur classement de l’article qui les place.
Trois leviers, donc. Pèsent-ils autant à chaque étage du classement ?
Plus on vise haut dans Google, plus l’écart lié à la qualité des liens est grand
Les trois leviers ont un point commun. Leur écart est plus grand pour le top 3 que pour le top 10.
| Levier | Top 10 | Top 3 |
|---|---|---|
| Liens venant d’articles du top 10 | +28 % | +41 % |
| Ancre tirée de la requête | +44 % | +65 % |
| Ancres précises données | +22 % | +36 % |
Chaque chiffre est la hausse des chances de classement qui va avec le levier. Par exemple, une page a 44 % de chances en plus d’être dans le top 10 sur une requête d’où sont tirées ses ancres.
Autrement dit, plus on vise haut dans Google, plus la qualité des liens va avec un écart important. Peu de pages atteignent le top 3, donc nous rapportons chaque écart à son point de départ plutôt qu’en points.
En position 1, seul le levier de la source montre un écart démontré, les 65 % vus plus haut.
Pour les trois leviers, l’écart relatif est plus grand pour le top 3 que pour le top 10.
Les rédacteurs relient-ils simplement ce qui marche déjà ?
C’est l’objection que tout lecteur attentif soulève, et cela arrive sûrement en partie. Les rédacteurs relient peut-être d’abord les articles déjà classés, et nous avons relevé les liens en octobre, après la mesure des positions.
Plusieurs résultats rendent peu probable que ce soit toute l’explication.
- Le résultat sur la source tient quand les sujets sont aussi porteurs.
- Le résultat sur l’ancre compare une page avec elle-même.
- Le résultat sur les ancres données tient après un contrôle plus serré de l’âge.
Nos données ne peuvent pas pour autant l’exclure. C’est pourquoi nous préparons une expérience sur le site d’un client.
Ce qui nous ramène à la question de départ, celle de savoir si le simple fait d’être relié compte encore.
Sur HubSpot, être relié va avec plus de chances d’apparaître dans Google, pas d’être en haut
Commençons par l’étendue du maillage. HubSpot n’est pas mieux relié que les blogs des éditeurs.
- 51,5 % des articles de HubSpot ne sont pas reliés dans les deux sens, contre 47,3 % chez les éditeurs.
- 15,6 % sont isolés, sans lien contextuel reçu ni donné, contre 16,5 %.
- Un article compte en moyenne 3,5 liens contextuels avec d’autres articles, contre 3,2.
Même un blog de la taille de HubSpot laisse un article sur six sans aucun lien contextuel, ni reçu ni donné.
51,5 % des articles de HubSpot ne sont pas reliés dans les deux sens, contre 47,3 % sur les six blogs d’éditeurs.
Pourtant, l’écart qui ressortait chez les éditeurs a disparu. Prenez 100 articles isolés de HubSpot et 100 articles reliés dans les deux sens, de longueur, d’âge, de backlinks et de section comparables.
- Dans le top 10. 30 articles isolés contre 33 articles reliés, un écart non significatif. Chez les éditeurs, c’était 33 contre 47.
- Dans le top 100. Être relié va encore avec 6,9 points de plus, un écart qui tient dans toutes les variantes testées.
Sur HubSpot, être relié va avec plus de chances d’apparaître dans Google, pas d’être en haut.
Isolé contre relié dans les deux sens, 30 % contre 33 % de top 10 sur HubSpot, et 33 % contre 47 % chez les éditeurs.
Placer plus de liens dans un article ne va avec rien de plus
La première étude laissait ouverte la question du nombre de liens utiles au-delà du premier. Sur HubSpot, multiplier les liens dans un article ne va pas avec un meilleur classement.
Nous avons classé les articles selon le nombre de liens qu’ils donnent, en quatre groupes égaux, avec typiquement 1, 3, 5 et 7 liens.
- Articles qui ne donnent aucun lien. 31 % dans le top 10.
- Articles qui en donnent 1, 3, 5 ou 7. 33 à 34 %, quel que soit le nombre.
Cela ne contredit pas l’analyse de 23 millions de liens internes, où les pages recevant plus de liens, menus compris, avaient plus de clics jusqu’à environ 45.
Elle mesurait les liens reçus et les clics, alors que nous mesurons les liens placés dans le texte et les positions.
Pourquoi, alors, les deux études racontent-elles des histoires différentes ?
La différence avec les éditeurs tiendrait au site entier
HubSpot et les six blogs d’éditeurs diffèrent sur presque tout ce qui fait la force d’un site. Le rang du domaine, la difficulté des requêtes et les backlinks viennent de DataForSEO.
| HubSpot | Six blogs d’éditeurs | |
|---|---|---|
| Articles | 7 461 | 301 par blog en moyenne |
| Âge médian | 6,1 ans | 2,3 ans |
| Articles sans backlink | 0,3 % | 76,5 % |
| Rang du domaine, sur 1 000 | 681 | 214 à 343 |
| Difficulté médiane des requêtes, sur 100 | 13 | 0 |
Les backlinks comptent bien sur HubSpot. Un article isolé avec 100 domaines référents a 42 % de chances d’être dans le top 10, contre 17 % avec un seul.
Nous avons ensuite regardé les articles de HubSpot qui ressemblent le plus à ceux des éditeurs, avec peu de backlinks, récents ou sur des requêtes faciles. Même là, être relié ne va pas avec plus de top 10.
Notre hypothèse est que la différence tient au site entier, autorité du domaine en tête. Un seul site ne permet pas de la confirmer, nous la vérifierons donc sur plusieurs.
Notre position. Nous y voyons une raison de travailler le maillage interne davantage à mesure qu’un site grandit, pas moins. L’autorité permet de se battre sur des requêtes plus compétitives, où le top 3 décide, et c’est là que la qualité des liens va avec les plus grands écarts.
C’est aussi un levier que peu de sites exploitent pleinement, HubSpot compris.
Juger chaque lien interne à son ancre et à sa source
Le travail part d’une liste, celle des articles du blog avec leurs positions et les liens contextuels qu’ils reçoivent et donnent.
- 1
Repérer les articles déjà dans le top 10
Dans la Google Search Console, listez les articles qui sont dans le top 10 sur au moins une requête. Ce sont les meilleurs endroits d’où faire partir un lien.
- 2
Choisir les articles qu’ils pourraient relier
Cherchez des articles sur un sujet voisin qui se classent moins bien ou ne reçoivent aucun lien contextuel. Placez le lien là où ce sujet apparaît naturellement dans le texte.
- 3
Écrire l’ancre avec les mots que vise la page
Prenez au moins deux mots d’une requête que vise la page de destination, idéalement des mots de son H1, comme « NPS surveys » pour « nps survey ». Inutile d’y faire entrer toute la requête.
- 4
Suivre l’évolution
Notez la date, puis suivez les positions des pages reliées sur leurs requêtes cibles. Laisser de côté quelques articles comparables aide à distinguer l’effet de la tendance générale du blog.
Pour quelques dizaines d’articles, un tableur suffit. Au-delà, Unveil SEO trouve les liens entrants et sortants dans le texte des articles existants, avec des ancres de deux à cinq mots, et fait ressortir les articles isolés.
Les questions que nous voulons trancher
Cette étude répond à une partie des questions laissées ouvertes par la première, sur l’ancre, le nombre de liens et le top 3. Elle en ouvre d’autres, regroupées selon la façon dont nous comptons y répondre.
- Une expérience sur le site d’un client, pour voir si les articles qui gagnent des liens bien choisis se classent ensuite mieux, et donc dans quel sens va la relation.
- D’autres grands sites, pour vérifier si la différence avec les éditeurs tient à l’autorité du domaine, et si ces leviers valent au-delà de HubSpot, dans d’autres langues et d’autres secteurs.
- Le mécanisme des ancres données, puisque nos données montrent que les articles aux ancres précises sont plus souvent en haut, sans dire pourquoi.
- Les réponses des IA, pour savoir si la qualité des ancres et des sources va aussi avec les citations dans la recherche IA, ce que nous n’avons pas mesuré ici.
Nous mettrons cet article à jour à chaque étape.
Méthode et données
Nous avons relevé les liens internes de 7 472 articles du blog de HubSpot avec le crawler Unveil SEO, puis les avons croisés avec leurs positions Google aux États-Unis, de juillet à octobre 2026, d’après DataForSEO.
Seuls les écarts significatifs sont présentés comme des constats.
Le site et les articles
L’étude porte sur les articles en anglais de blog.hubspot.com, hors page d’accueil, pages de liste et pages thématiques. Les comparaisons qui tiennent compte de l’âge écartent 11 articles non datés, d’où 7 461 articles face aux éditeurs.
Les sources
| Donnée | Source |
|---|---|
| Liens internes | Crawler Unveil SEO, 22 octobre 2026 |
| Positions Google aux États-Unis | DataForSEO Labs, juillet à octobre 2026 |
| Backlinks | DataForSEO Backlinks, domaines référents, décompte brut |
| Âge des articles | Première capture dans la Wayback Machine |
| Proximité de sujet | Titres, H1, meta descriptions et URL |
HubSpot republie régulièrement ses articles, et les dates qu’il affiche marquent la dernière mise à jour. L’âge vient donc de la première capture dans la Wayback Machine.
Le classement des liens
Un lien est contextuel quand il se trouve dans le texte d’un autre article de l’étude, avec les règles de la première. Suggestions, boutons, images et liens des pages de liste sont écartés, d’où 26 228 couples d’articles reliés.
La comparaison des articles
- Au niveau de l’article, chaque résultat vient d’une régression logistique à longueur, âge, domaines référents et section comparables, avec des fourchettes à 95 % par rééchantillonnage au sein de chaque section.
- Au niveau de la requête, chaque page est comparée à elle-même sur 180 039 couples page et requête, en tenant compte de la requête dans le H1 ou le titre, de son volume et de sa difficulté.
- Pour les sources, un sujet est porteur selon la part des 10 articles les plus proches de sujet qui sont dans le top 10, hors articles qui relient la page.
Robustesse
- L’écart de top 100 lié au fait d’être relié est significatif dans les 8 variantes testées.
- Le résultat sur les ancres données tient avec l’âge en années et un terme au carré, et avec la date de republication de HubSpot.
- En contrôle, une page ne se classe pas mieux sur une requête présente dans une ancre qu’elle donne vers un autre article (3,3 points de top 10 en moins). Le résultat sur l’ancre concerne les ancres reçues.
- Les backlinks sont comptés bruts, spam compris. Sur un échantillon de 200 articles, 12 % des domaines référents ressemblaient à du spam, sans écart suffisant entre groupes pour justifier un filtre.
Limites
- L’étude montre une association, pas une preuve d’effet, et les liens ont été relevés après les positions.
- Elle porte sur un seul site, en anglais, sur Google aux États-Unis.
- Les positions sont estimées par DataForSEO, qui ignore les requêtes de moins d’une dizaine de recherches par mois et ne garde qu’une page HubSpot par requête.
- La position 1 repose sur peu de cas, 298 articles et 620 requêtes.
- L’âge des articles est mesuré grossièrement, d’après la première capture dans la Wayback Machine.
- 595 liens vers d’anciennes URL qui redirigent ne sont pas comptés (1,9 % des liens), et le texte des articles n’ayant pas été exporté, la présence de la requête dans les sous-titres n’est pas contrôlée.
Citer cette étude
Unveil SEO, Qualité des liens internes et positions Google, étude sur 7 472 articles du blog de HubSpot, novembre 2026, https://unveilseo.com/fr/blog/etude-maillage-contextuel-hubspot. Les graphiques peuvent être repris librement, avec un lien vers cette page.